SM 以 wrap 为基本单位调度线程。
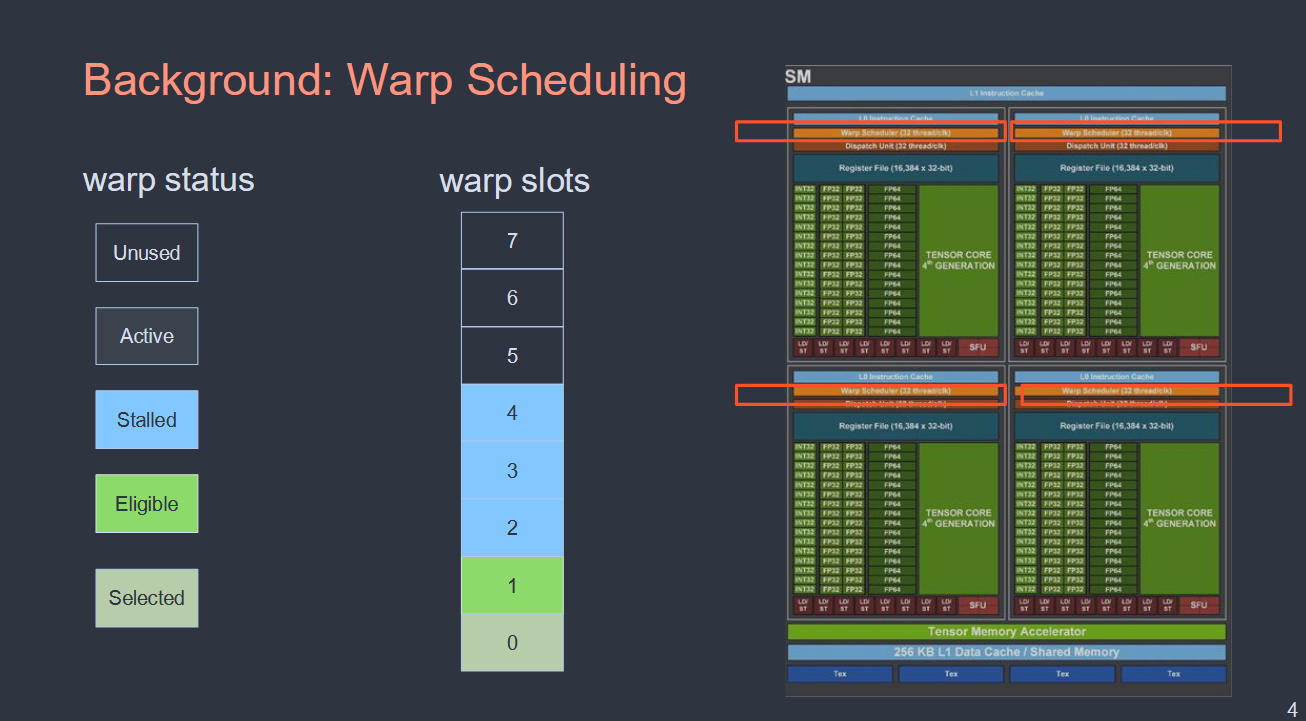
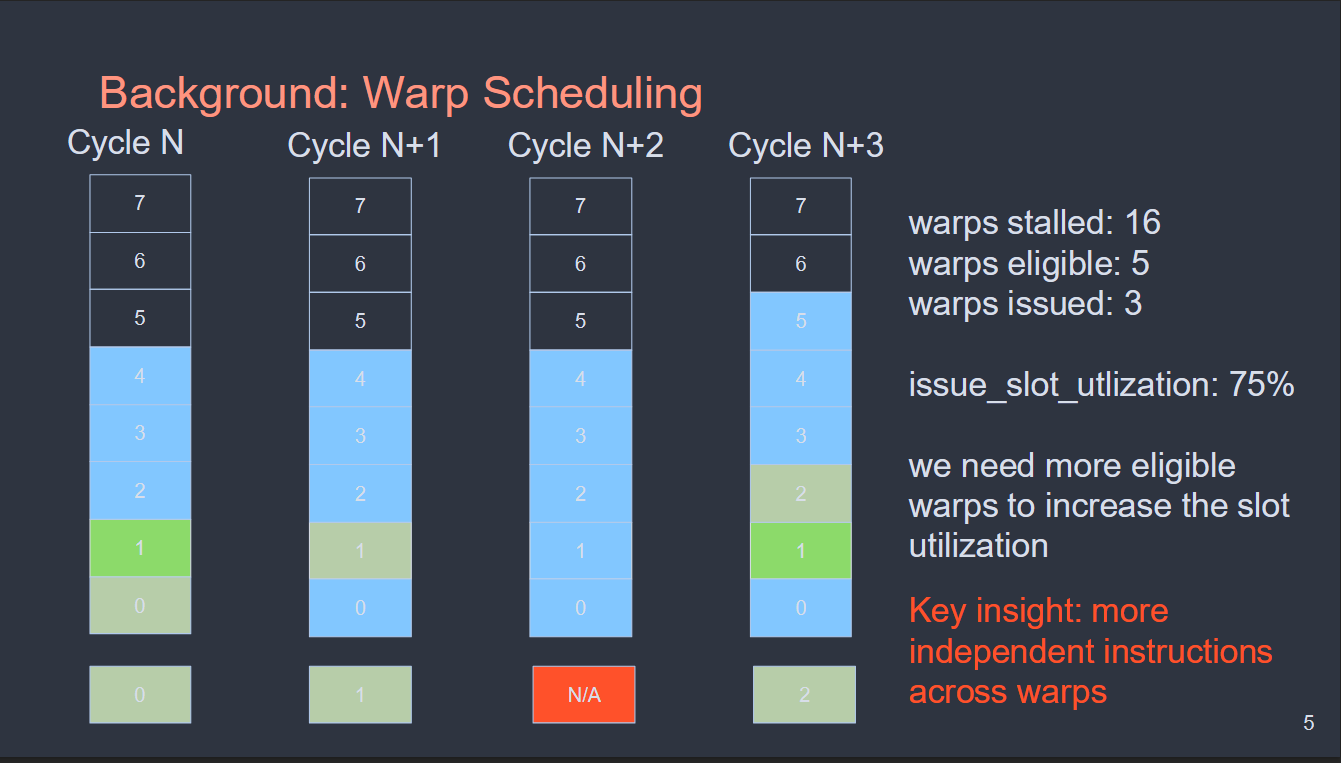
这张图展示的是 GPU Streaming Multiprocessor (SM) 中 Warp 调度器的状态机与 Slot 占用示意。它解释了 SM 如何在一个时钟周期(cycle)内管理多个 Warp 的执行资格。
左侧展示了 Warp 的五种状态:
| 状态 | 含义 |
|---|---|
| Unused | 该 warp slot 空闲,当前没有线程块(Thread Block)分配到它。 |
| Active | 已被线程块占用,处于活跃上下文中(可进一步细分为就绪、停滞或执行中)。 |
| Stalled | Warp 的下一条指令尚未准备好,通常因等待数据返回(如全局内存加载)、寄存器依赖或同步屏障而卡住。 |
| Eligible | Warp 的指令已就绪,有资格被调度器选中执行。 |
| Selected | 在当前时钟周期被调度器选中,正在向执行单元(CUDA Core / Tensor Core 等)发射指令。 |
展示了 Warp Slots 的实时状态。
右侧 0–7 号 slot 代表 SM 上可同时维护的若干 warp 上下文。图中展示了一个典型的周期快照:
- Slot 0(Selected):当前周期正在执行指令。
- Slot 1(Eligible):已就绪,等待调度器在下一周期选中它。
- Slots 2–4(Stalled):因数据未就绪而停滞,暂时无法执行。
- Slots 5–7(Unused):空闲,未被任何线程块使用。
SM 的发射槽(issue slot)利用率直接取决于 Eligible Warp 的数量。如果太多 Warp 同时 Stalled(如图中的 Slots 2–4),而 Eligible 的候选太少,调度器就会“无指令可发”,导致执行单元空转。为了用计算掩盖内存延迟,需要保持足够多的独立指令流——也就是让更多 Warp 处于 Eligible 状态,随时能顶替上去被 Selected,从而把 issue slot 利用率推向 100%。
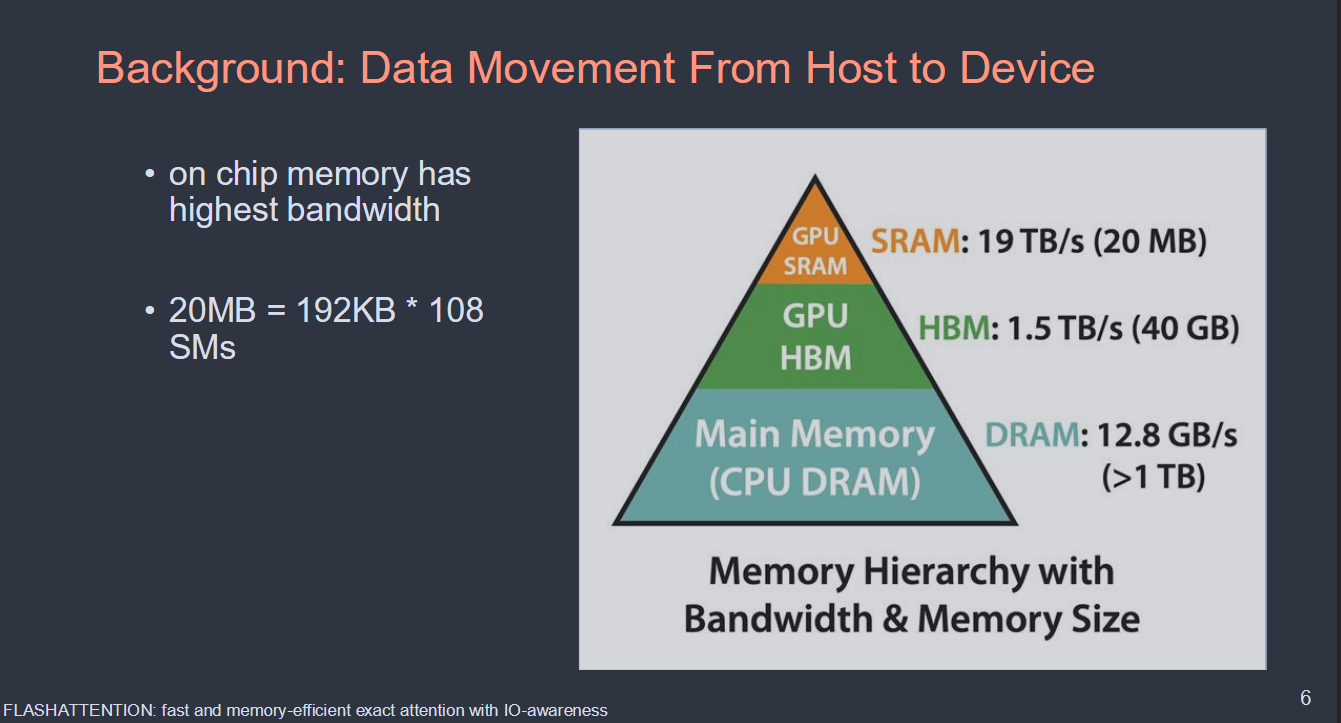
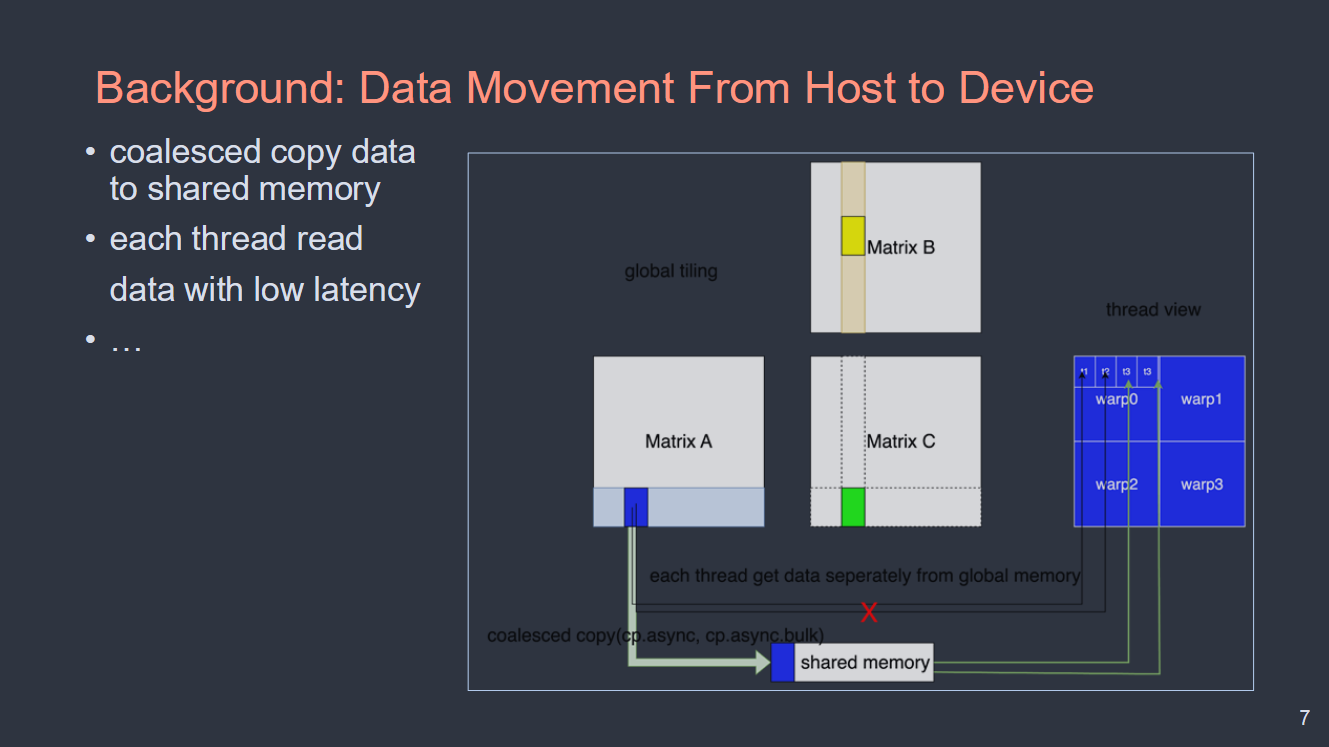
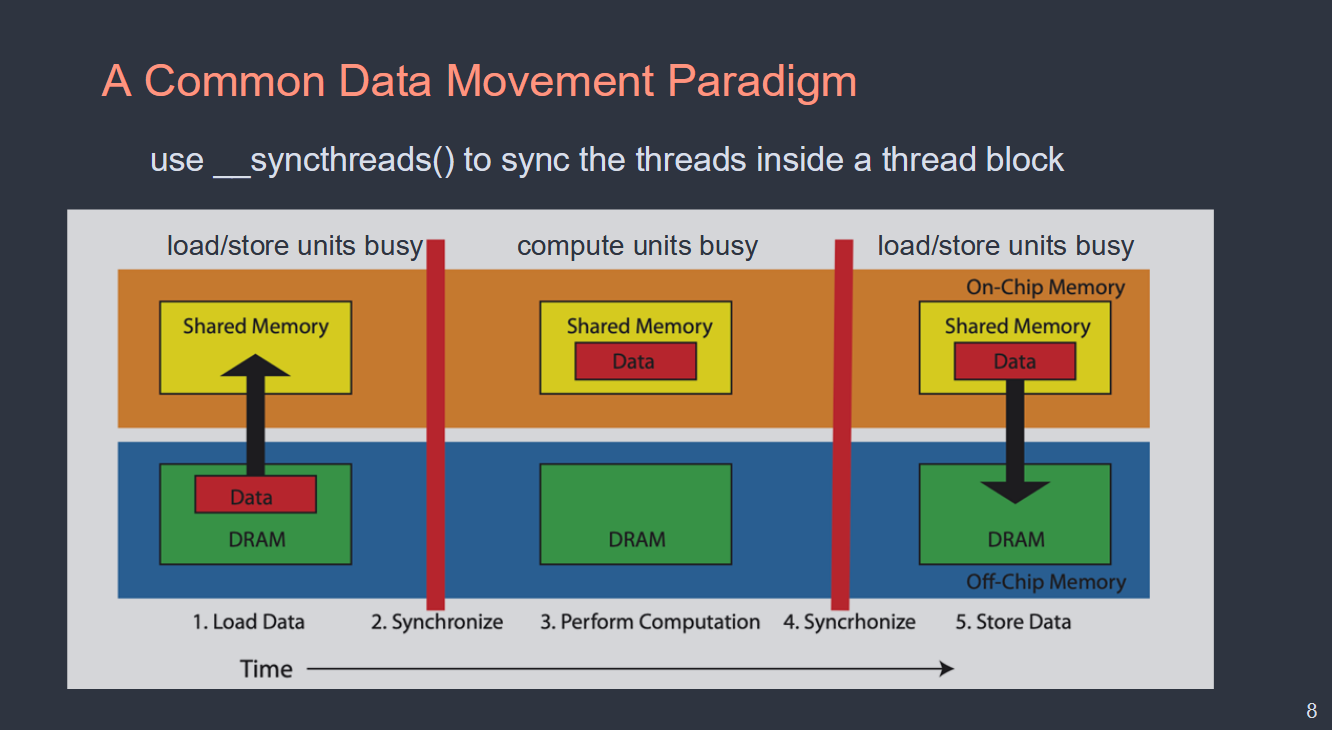
在之前的章节中我们已经对 Global Memory、Shared Memory 等存储层次结构有了一定的理解。一个普遍的范式是:从 DRAM 读取一批数据到 Shared Memory,让多个工作的 Thread 共享这些数据的读写,然后再把结果写回 DRAM。为了防止脏数据,我们会使用 __syncthreads() 来同步线程块内的所有线程,确保所有线程在继续执行前都完成了对共享数据的访问。
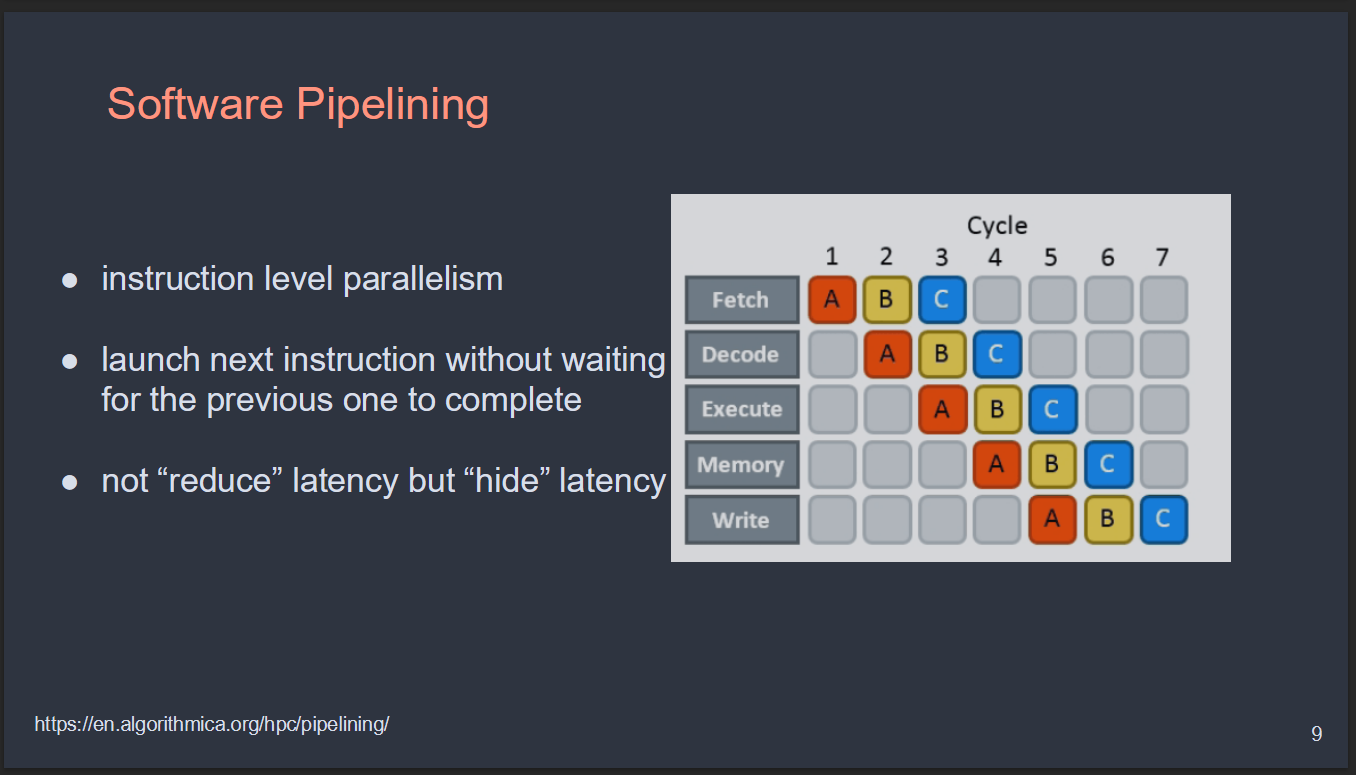
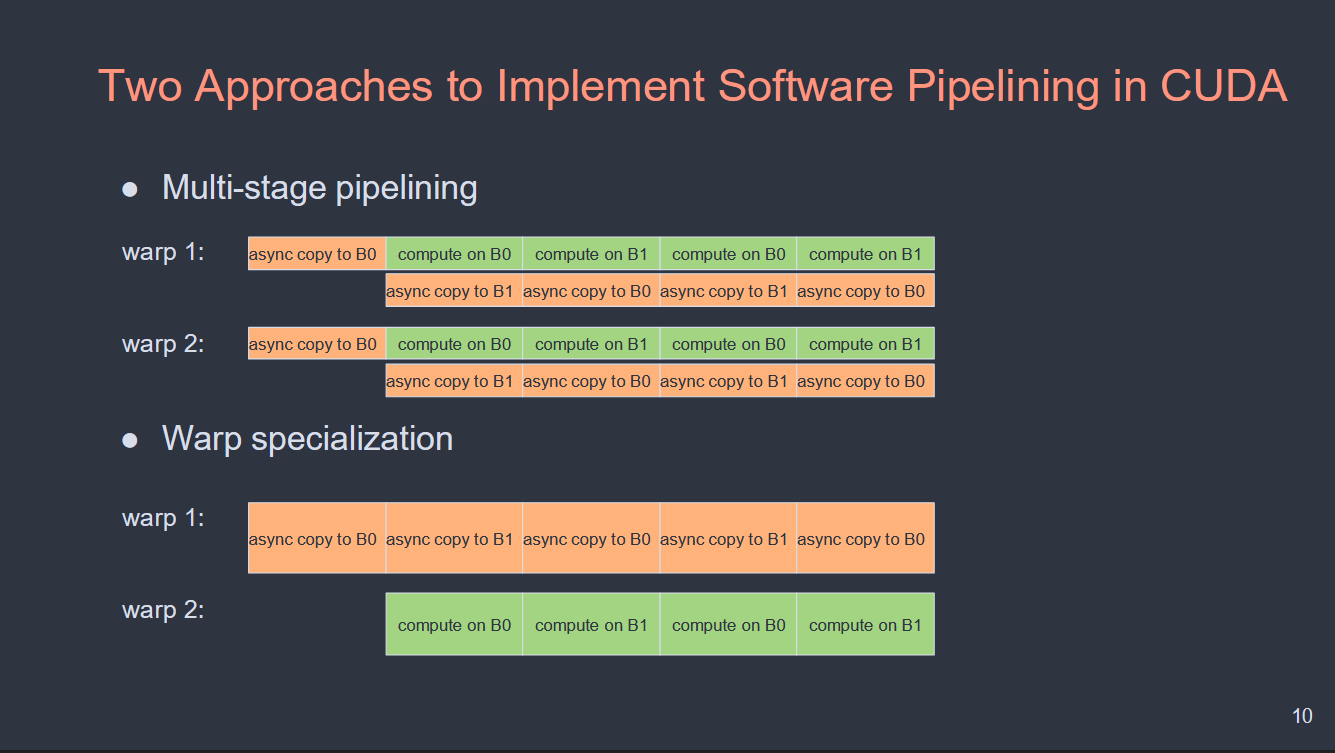
两种在 CUDA 中实现流水线的方式:
- Multi-stage Pipelining:同一个 Wrap 可以执行不同的阶段
- Wrap Specialization:每个 Wrap 专注于执行一个阶段
下面先讨论怎么在 CUDA 中实现 Multi-stage Pipelining。
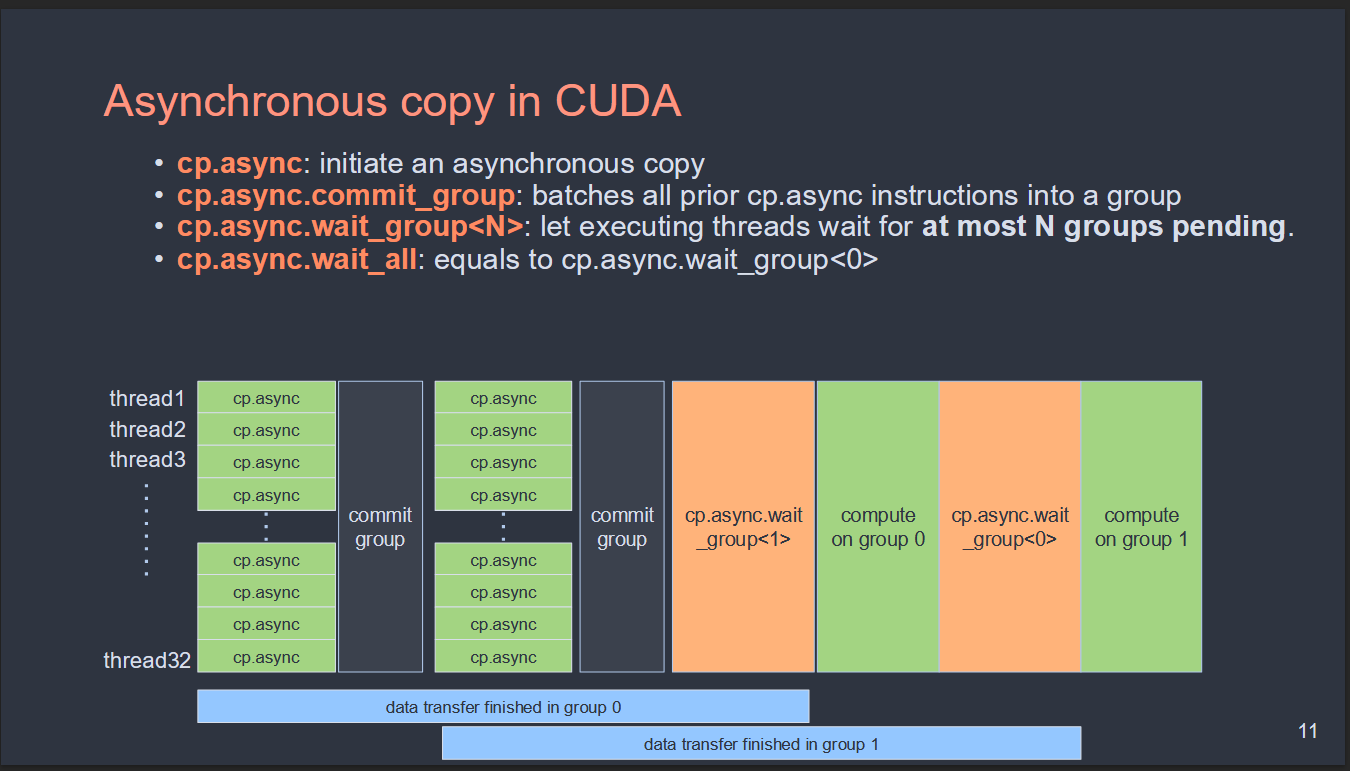
CUDA 中的异步 copy:
cp.async:从全局内存到共享内存的异步拷贝,发出指令后立即返回不阻塞;cp.async.commit_group:提交一组异步拷贝请求到一个 FIFO 的队列中;cp.async.wait_group<N>:最多容忍 N 个组未完成,即队列长度至多为 N;cp.async.wait_all:等待所有异步拷贝请求完成。
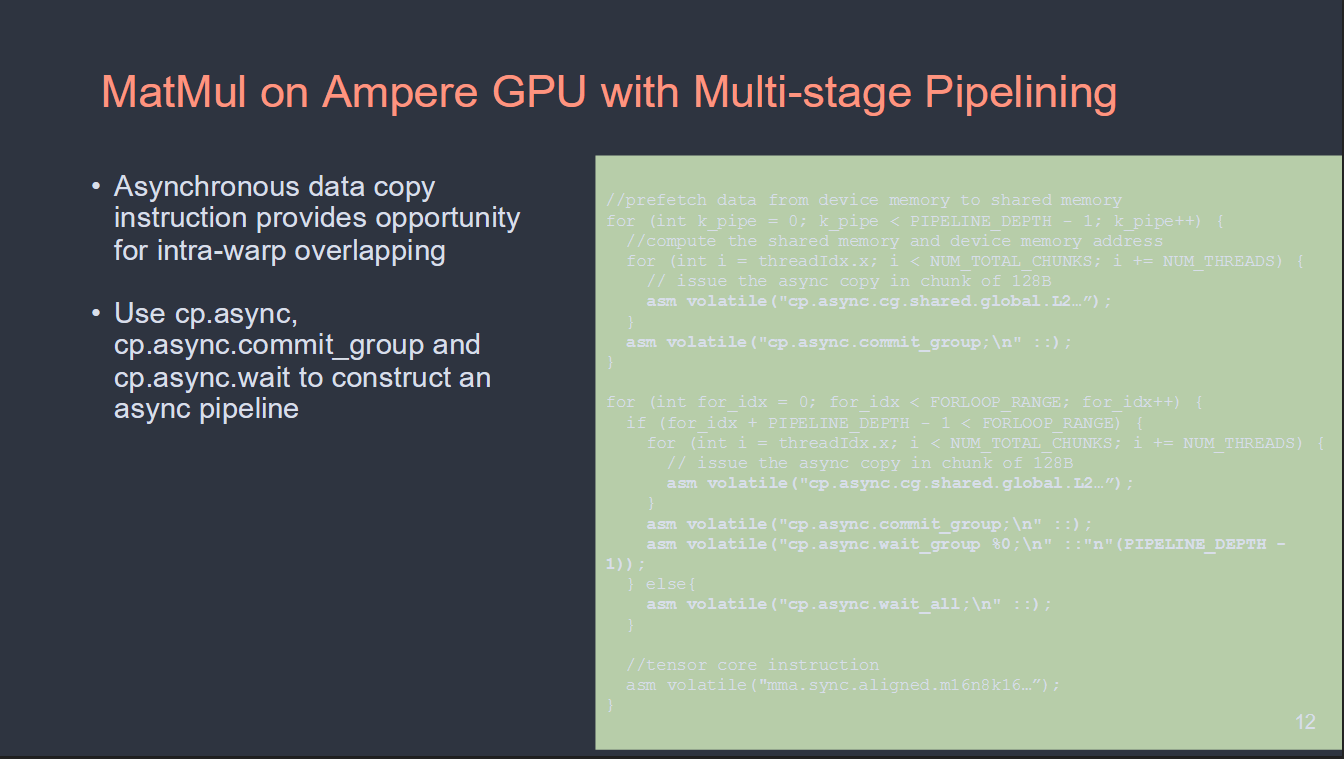
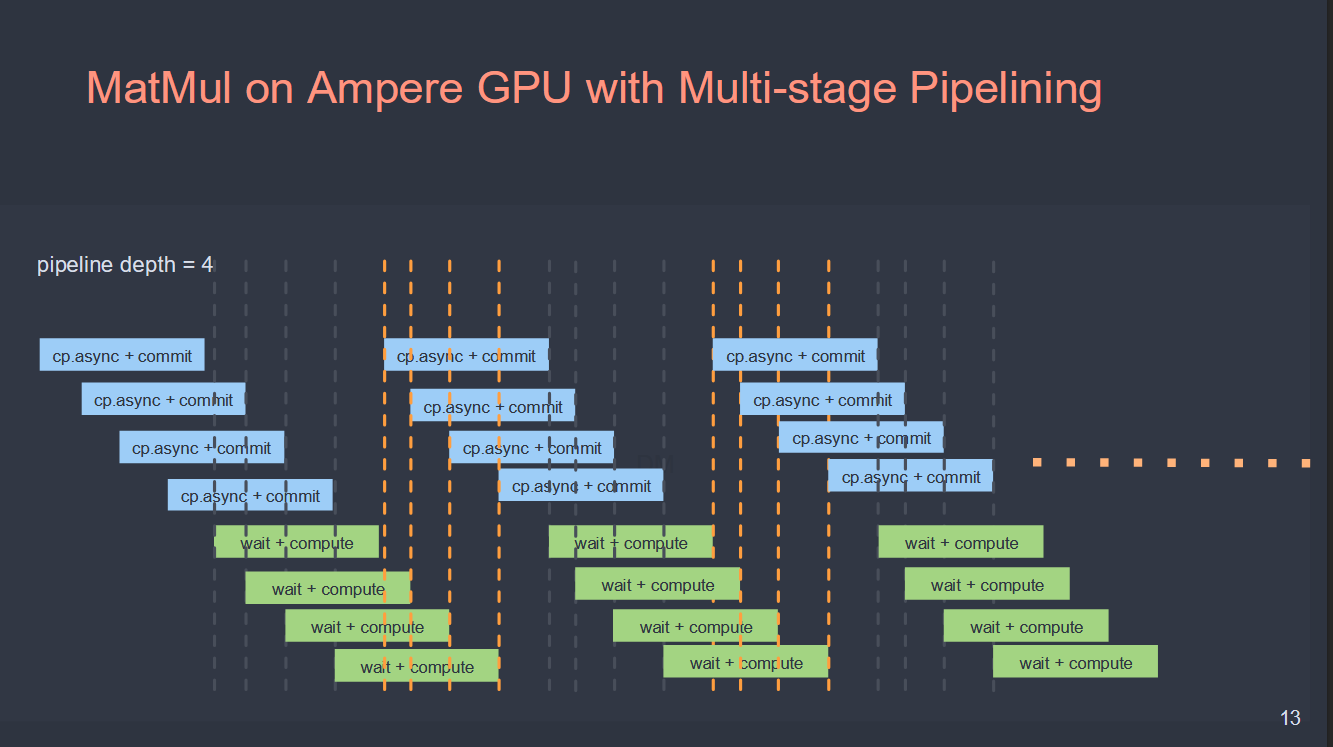
- 预取 D - 1 组数据到共享内存:
设 PIPELINE_DEPTH 为流水线深度 D,NUM_TOTAL_CHUNKS 为总数据块数,NUM_THREADS 为线程数。
for (int k_pipe = 0; k_pipe < PIPELINE_DEPTH - 1; k_pipe++) {
    for (int i = threadIdx.x; i < NUM_TOTAL_CHUNKS; i += NUM_THREADS) {
        // cp.async.cg.shared.global  128B chunk
        asm volatile("cp.async.cg.shared.global.L2::128B ...");
    }
    asm volatile("cp.async.commit_group;\n" ::);
}
NUM_TOTAL_CHUNKS 个 128B chunk 均摊给 NUM_THREADS 个线程,每个线程发 NUM_TOTAL_CHUNKS / NUM_THREADS 条 cp.async,然后 commit 一次打包成 1 个组。
- 主循环:
for (int for_idx = 0; for_idx < FORLOOP_RANGE; for_idx++) {
    if (for_idx + PIPELINE_DEPTH - 1 < FORLOOP_RANGE) {
        for (int i = threadIdx.x; i < NUM_TOTAL_CHUNKS; i += NUM_THREADS) {
            asm volatile("cp.async.cg.shared.global ...");
        }
        asm volatile("cp.async.commit_group;\n" ::);

        asm volatile("cp.async.wait_group %0;\n" ::"n"(PIPELINE_DEPTH - 1));
    } else {
        asm volatile("cp.async.wait_all;\n" ::);
    }
    asm volatile("mma.sync.aligned.m16n8k16 ...");
}
注意主循环预取的是第 for_idx + PIPELINE_DEPTH - 1 块(代码里通过地址计算隐含),不是 for_idx 本身。也就是说计算第 k 块时,发射的是第 k+D-1 块的拷贝。
wait_group<PIPELINE_DEPTH-1> 允许最多 D-1 个组未完成,保证了在计算第 for_idx 块时,for_idx 这个最早发出的拷贝能够及时完成。
Multi-stage Pipelining 的缺点:
粗粒度同步 Coarse-grained Synchronization:使用 FIFO 的队列及
wait_group完成读、算和写三个步骤之间的同步,这导致等的可能往往比实际使用的更多,想象 chunk 1 和 chunk 2 都已经完成,然而 chunk 0 没有完成,导致 chunk 1 和 chunk 2 都被阻塞,无法继续执行。地址生成开销 Address Generation Overhead:每个 Thread 都需要计算自己要读取和写入的地址,占用指令和寄存器资源。
指令流难以解耦 Hard to Decouple Instruction Streams:同一个 wrap 必须包含 producer 和 consumer 的指令流,导致 wrap 内部的指令流耦合,不够灵活。
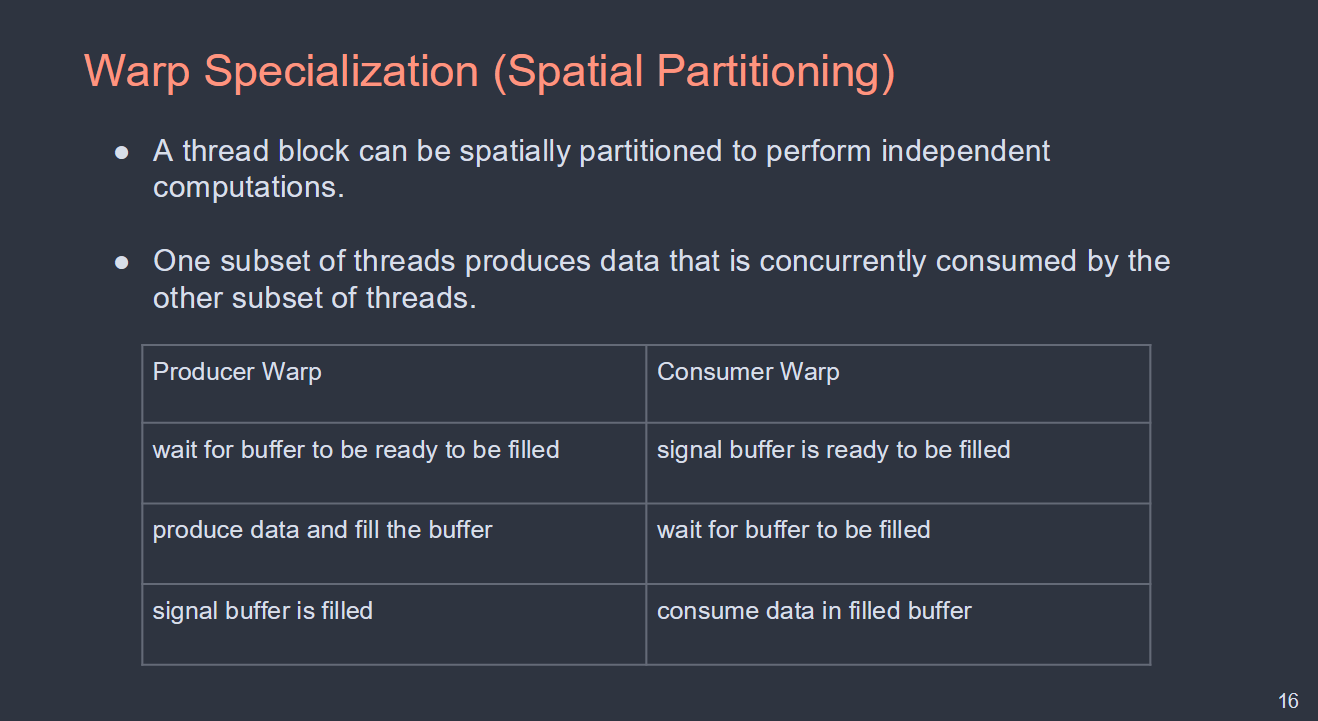
表格展示了 Wrap Specialization 的生产者和消费者之间的动作的对应关系:
| Producer Warp | Consumer Warp | 对应的 mbarrier |
|---|---|---|
| wait for buffer to be ready to be filled(等 buffer 空) | signal buffer is ready to be filled(通知 buffer 已空) | consumer 翻转 empty_barrier |
| produce data and fill the buffer(发射拷贝填充 buffer) | wait for buffer to be filled(等 buffer 满) | —(TMA 在搬 / consumer 在 wait full_barrier) |
| signal buffer is filled(通知 buffer 已满) | consume data in filled buffer(消费数据) | producer/TMA 翻转 full_barrier |
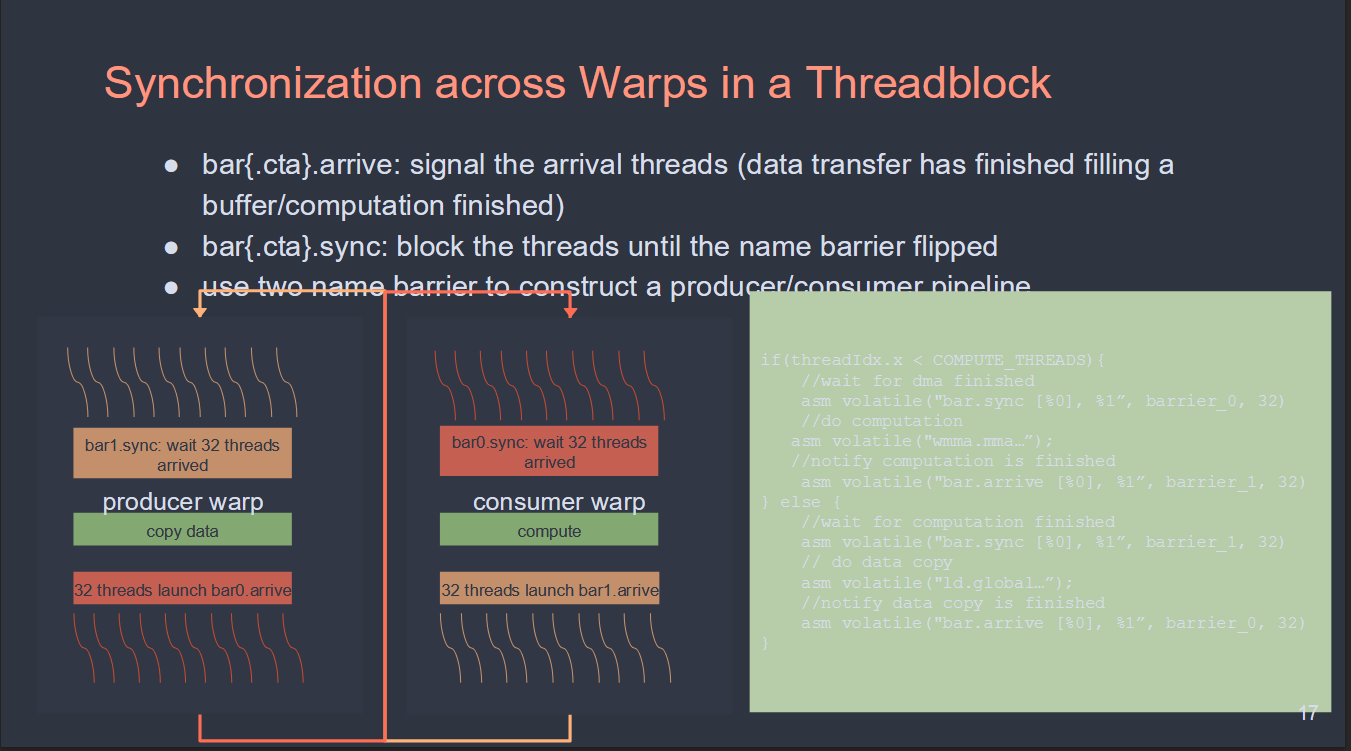
bar{.cta}.arrive表示线程的工作已经完成,等待其他线程到达屏障,非阻塞;bar{.cta}.wait表示线程等待屏障翻转,阻塞;
使用这两个指令可以实现 wrap 之间的同步,保证生产者 wrap 在消费者 wrap 消费数据之前不会覆盖 buffer。一个实现如下:
if (threadIdx.x < COMPUTE_THREADS) {          // ─── Consumer 分支 ───
    // wait for dma finished
    asm volatile("bar.sync [%0], %1;", barrier_0, 32);   // 等 barrier_0:拷贝完成
    // do computation
    asm volatile("mma.mma...");                          // Tensor Core 计算
    // notify computation is finished
    asm volatile("bar.arrive [%0], %1", barrier_1, 32);  // 对 barrier_1 报告:算完了

} else {                                       // ─── Producer 分支 ───
    // wait for computation finished
    asm volatile("bar.sync [%0], %1", barrier_1, 32);    // 等 barrier_1:buffer 空了
    // do data copy
    asm volatile("cpId.global...");                      // 拷贝数据(ld.global/st.shared)
    // notify data copy is finished
    asm volatile("bar.arrive [%0], %1", barrier_0, 32);  // 对 barrier_0 报告:拷完了
}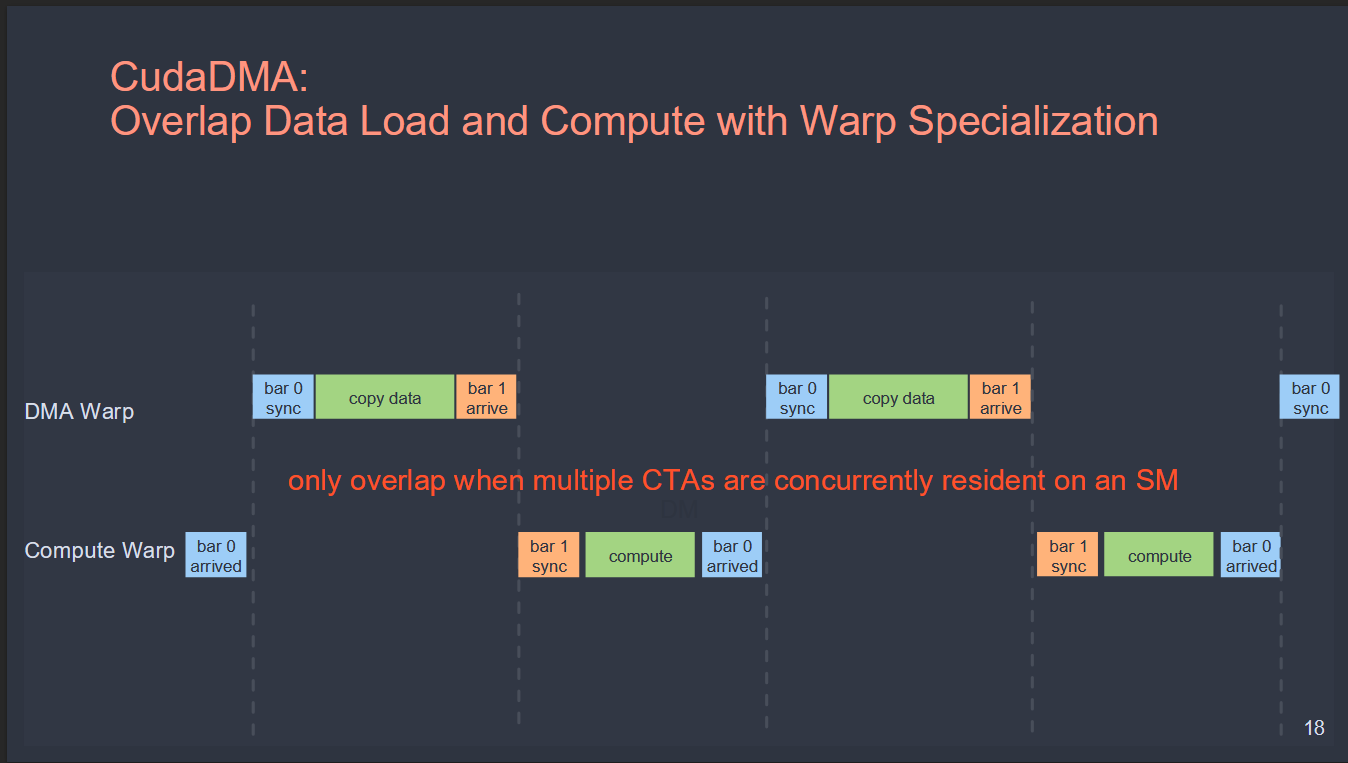
在早期的 CudaDMA 中,对于一个 CTA 看上去实际上是串行的,只有多个 CTAs 驻留时才能体现出优势,
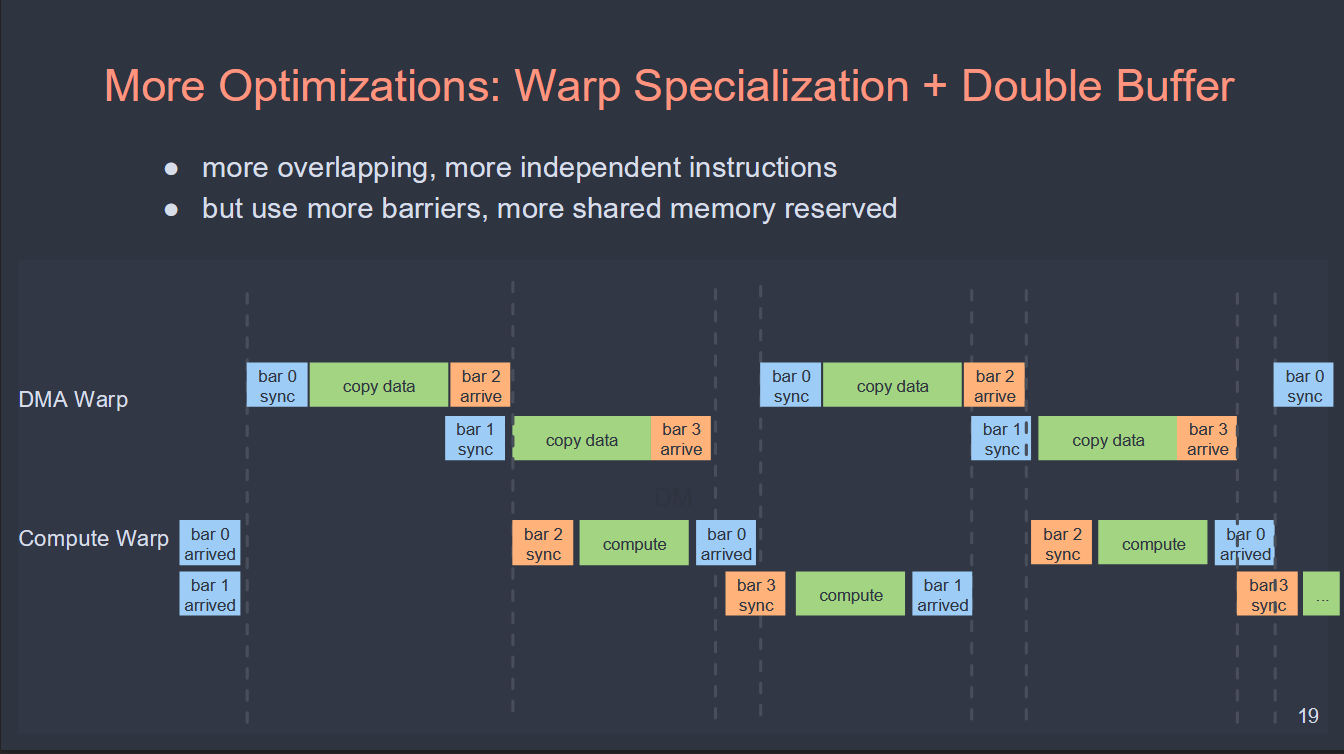
上文中 Wrap 之间的同步只使用了一个缓冲区,可以通过增加缓冲区数量来进一步优化,也进而会产生 2 * 2 = 4 个 mbarrier。之前讲过的两种优化在此融合:空间上拆了 warp(warp specialization),时间上拆了 buffer(double buffer)。
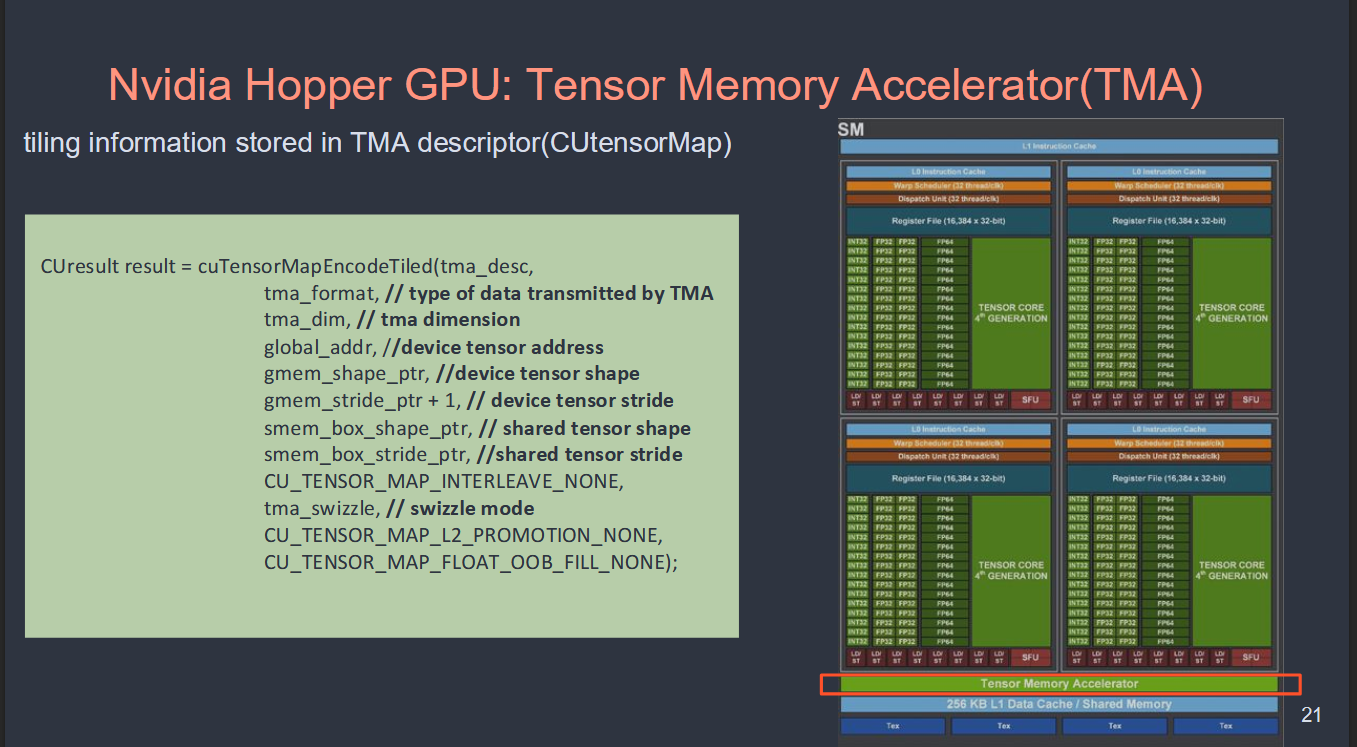
Hopper 架构引入了 Tensor Memory Accelerator (TMA),将地址计算等数据访问的复杂性从软件层(线程)剥离,交由专用硬件(TMA)处理,实现数据搬运与计算解耦。
CUresult result = cuTensorMapEncodeTiled(
    tma_desc,                        // 输出的描述符对象
    tma_format,      // type of data transmitted by TMA  —— TMA 传输的数据类型
    tma_dim,         // tma dimension                    —— 张量维度(1~5 维)
    global_addr,     // device tensor address            —— 显存中张量的基地址
    gmem_shape_ptr,  // device tensor shape              —— 全局张量的形状
    gmem_stride_ptr + 1, // device tensor stride         —— 全局张量的步长
    smem_box_shape_ptr,  // shared tensor shape          —— 每次拷贝的 box(分块)形状
    smem_box_stride_ptr, // shared tensor stride         —— box 内部元素的步长
    CU_TENSOR_MAP_INTERLEAVE_NONE,       // 交错模式
    tma_swizzle,     // swizzle mode                     —— SMEM swizzle 模式
    CU_TENSOR_MAP_L2_PROMOTION_NONE,     // L2 缓存提升粒度
    CU_TENSOR_MAP_FLOAT_OOB_FILL_NONE);  // 越界填充方式
核心设计思想:把“拷贝什么、从哪拷到哪、怎么分块”全部预先编码进一个硬件可读的描述符对象,运行时线程只需发一条指令引用它。
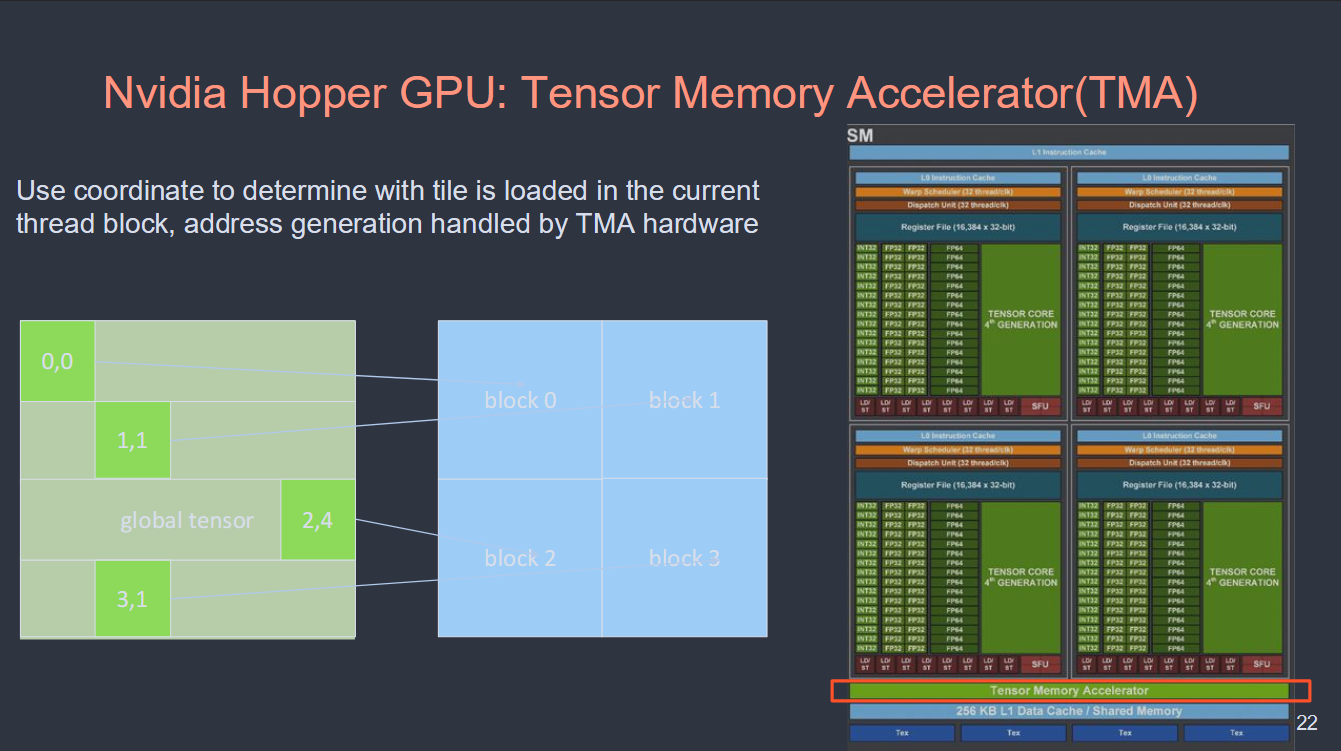
一个 global 张量被切成 tile 网格,每个 CTA 负责其中一个(或几个)tile。CTA 发 TMA 指令时只传坐标(如 cp.async.bulk.tensor [smem], [tma_desc], {2, 4}),硬件根据描述符里的 shape/stride 自动算出 gmem 源地址和 smem 目标地址。
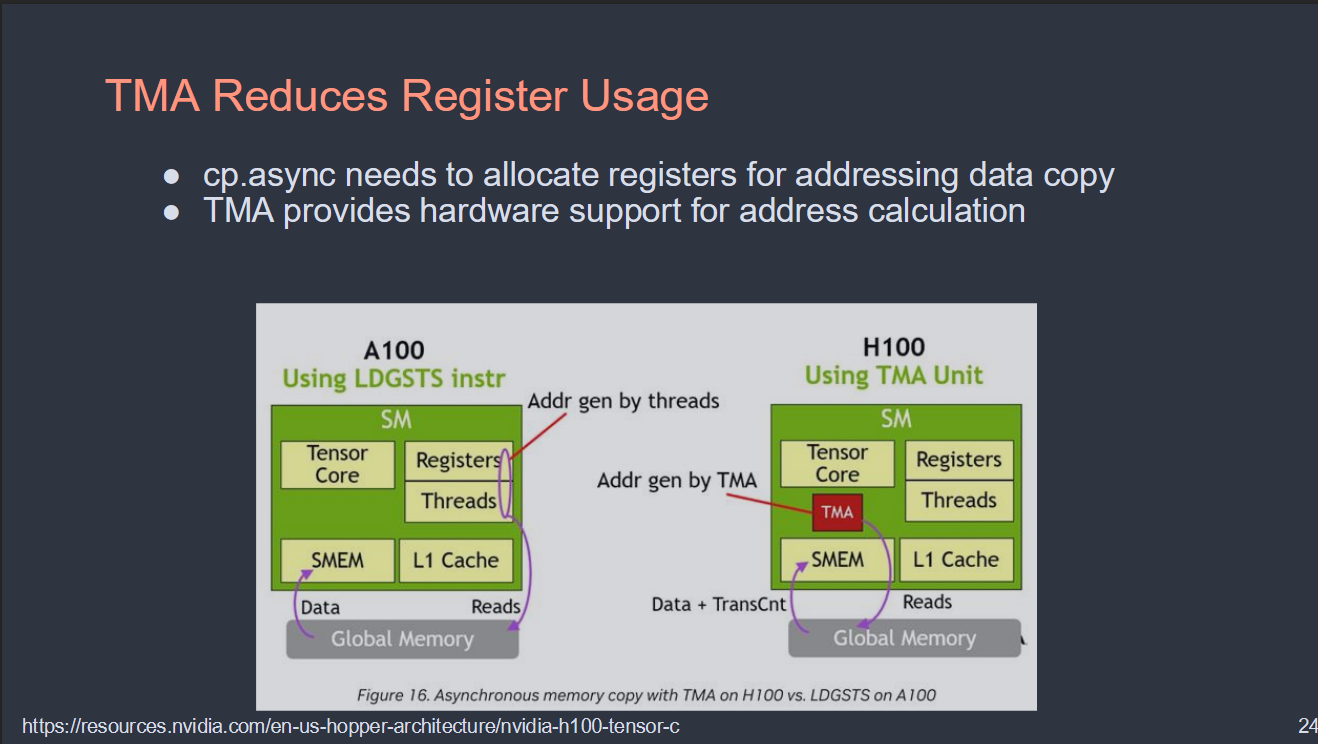
对比之下,TMA 可以显著减少 Registers 的使用。
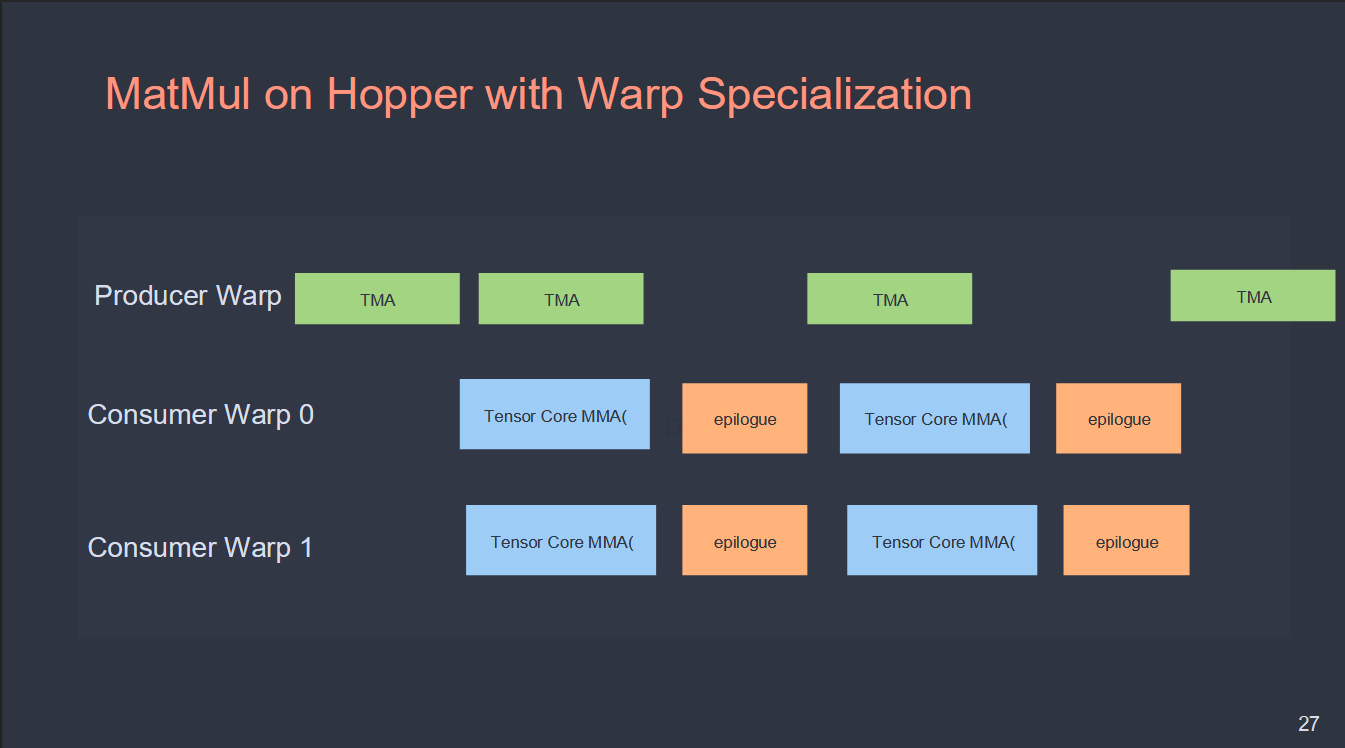
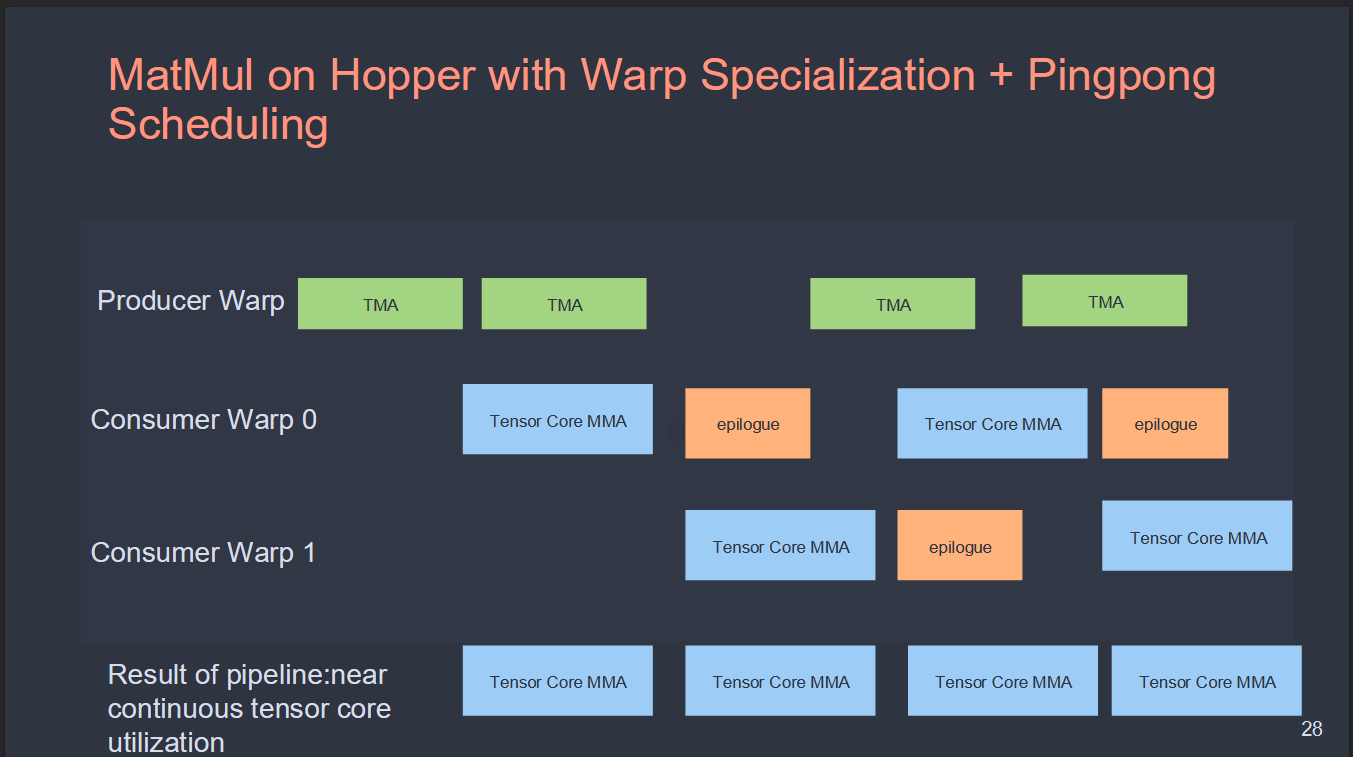
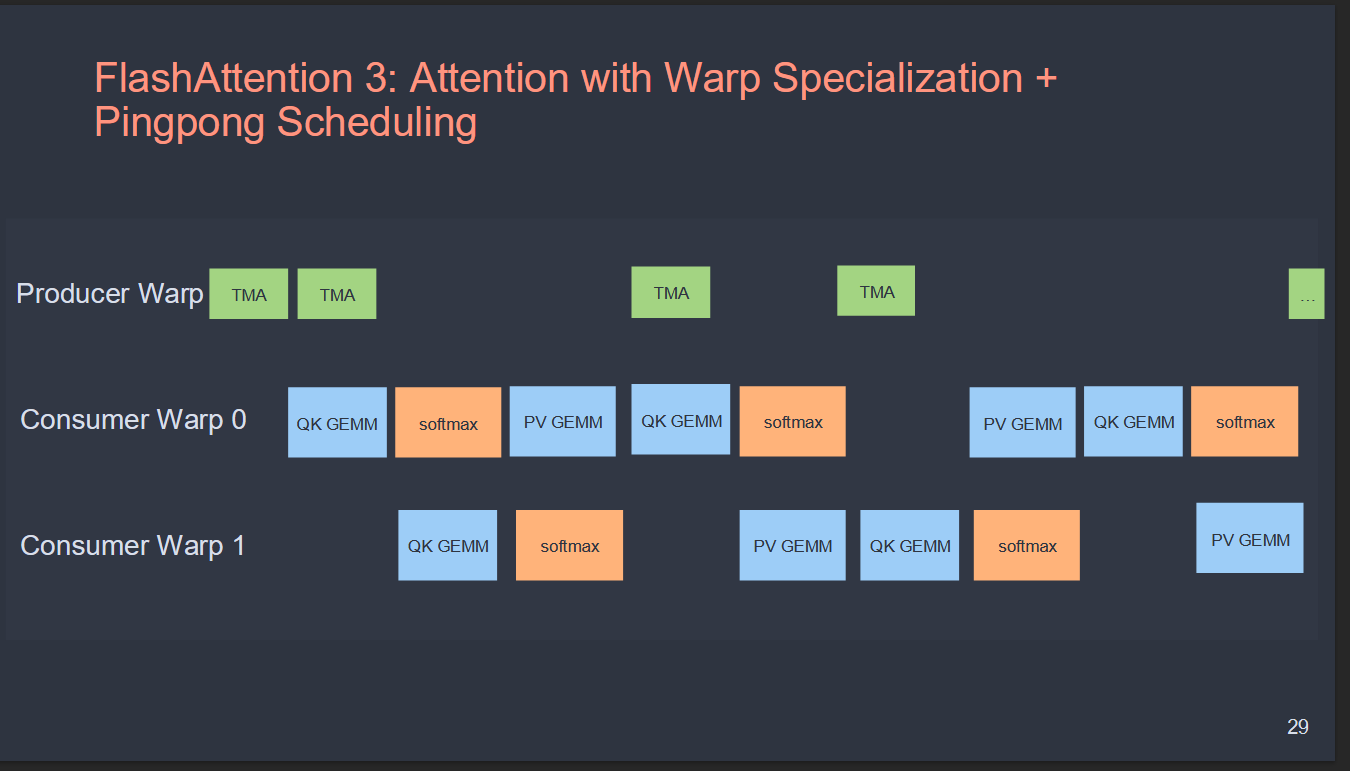
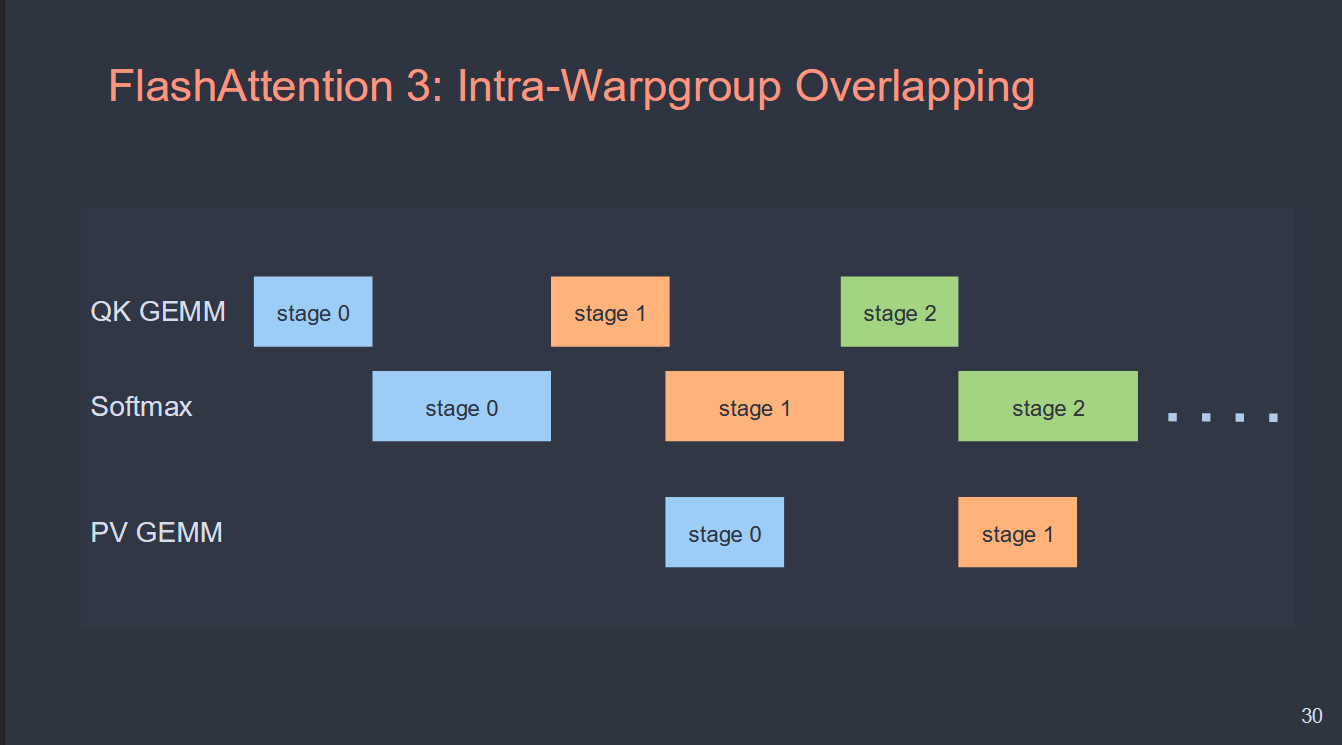
这两张图构成一组“问题—解法”对照:第 27 页展示 Hopper warp specialization GEMM 的遗留瓶颈——两个 consumer warpgroup 绑定同步,一起做 MMA 时 Tensor Core 虽满载、但一起做 epilogue 时 Tensor Core 集体空转;第 28 页的 Pingpong Scheduling 让两个 consumer warpgroup 交错运行(一个的 MMA 嵌进另一个的 epilogue 的时间窗里),从 Tensor Core 视角看 MMA 几乎连续不断,达到 “near continuous tensor core utilization”——至此,拷贝、计算、写回三类工作在 warp specialization 框架下全部实现了相互重叠。